


Introducción
Llevo bastante tiempo utilizando agentes de inteligencia artificial para agilizar mis flujos de trabajo, desarrollar pruebas de concepto y crear pequeñas aplicaciones, lo que llamaríamos vibe coding. Sin embargo, quería ir un paso más allá y comprobar hasta dónde podían ayudarme en un proyecto de mayor envergadura, especialmente si se trataba de una aplicación desarrollada por otras personas y en un entorno tecnológico con el que no estaba familiarizado. Aunque mi experiencia profesional está centrada en el desarrollo de firmware, abordar una aplicación Android con una base de código extensa y numerosas dependencias suponía un reto diferente, tanto por las tecnologías utilizadas como por la necesidad de comprender decisiones de diseño tomadas anteriormente.
Mi interés por la inteligencia artificial también me ha llevado a experimentar con ella en otros ámbitos, como cuando conseguí ejecutar un modelo de lenguaje localmente en una Orange Pi RV2. Sin embargo, esta vez quería explorar una aplicación diferente de estas tecnologías, utilizando agentes de IA para comprender, modificar y modernizar un proyecto de software que no había desarrollado yo.
Aplicar el vibe coding a un proyecto heredado
La oportunidad surgió con Mimi Reader, una aplicación Android para navegar por 4chan que llevaba años sin mantenimiento, pero cuyo código fuente seguía disponible. Como usuario, conocía sus funcionalidades y algunos de sus problemas, así que decidí aprovecharla para experimentar con las posibilidades del vibe coding y el desarrollo asistido por IA. Mi objetivo no era únicamente recuperar y modernizar la aplicación, sino también evaluar hasta qué punto un agente podía ayudarme a comprender un proyecto existente, identificar problemas, proponer soluciones y automatizar tareas, así como determinar dónde seguían siendo necesarios mis conocimientos, mi intervención y la validación de los resultados.
El resultado fue Mimi Reader 8.0, una continuación independiente que puede descargarse desde GitHub. Sin embargo, llegar hasta ahí exigió bastante más que generar código: tuvimos que diagnosticar problemas, planificar las modificaciones, modernizar componentes, incorporar funcionalidades y realizar pruebas. También revisamos las dependencias, documentamos las limitaciones y preparamos una versión firmada y verificable para su distribución.
En esta entrada comparto cómo abordamos el proceso, las dificultades que encontramos y las decisiones que continuaron dependiendo de mí. A partir de esta experiencia, reflexiono sobre las posibilidades del vibe coding y sobre la importancia de mantener el criterio técnico y la validación de resultados cuando utilizamos IA para desarrollar software.
Qué es el vibe coding y cómo encaja en este proyecto
La expresión vibe coding aparece a menudo para describir cualquier desarrollo acompañado por una IA. Le explicamos lo que queremos, recibimos código y ajustamos el resultado mediante una conversación. Sin embargo, esa descripción mezcla maneras de trabajar con niveles de revisión muy diferentes. Conviene distinguirlas antes de valorar sus resultados.
Simon Willison explica la diferencia entre el vibe coding y el desarrollo asistido por IA. En el vibe coding, la IA genera software sin revisar ni comprender el código. Esta distinción cobra especial importancia cuando la aplicación debe ser instalada y usada. Además, esto exige prestar mayor atención a su calidad, fiabilidad y seguridad.
Mi experiencia se enmarca en el desarrollo asistido por IA. Aunque el proceso incluyó interacción con el modelo, también contempló la generación de código y la experimentación. Además, revisé los resultados, identifiqué y reproduje errores, realicé pruebas automatizadas y validé los cambios introducidos.
Así, el vibe coding sirve como punto de partida para abordar el tema. Sin embargo, el trabajo realizado va más allá de la simple generación de código mediante IA. El objetivo no era únicamente recuperar una herramienta funcional, sino también comprender su funcionamiento y garantizar la calidad y fiabilidad del software desarrollado.
Linus Torvalds también recurre al vibe coding
El uso del vibe coding no se limita a personas sin experiencia en programación. Incluso Linus Torvalds, creador del kernel de Linux y una de las figuras más reconocidas del desarrollo de software, ha recurrido a estas herramientas para trabajar con tecnologías fuera de su especialidad. En su proyecto personal AudioNoise, dedicado a experimentar con efectos digitales de audio, explica que utilizó Google Antigravity para desarrollar un visualizador de muestras en Python, un lenguaje con el que reconoce estar poco familiarizado. En el README del proyecto lo cuenta con estas palabras:
The python visualizer tool has been basically written by vibe-coding.
Este caso me parece especialmente ilustrativo, ya que Linus reconoce haber utilizado vibe coding para desarrollar una interfaz gráfica en Python, debido a que es un lenguaje con el que no está especialmente familiarizado. Este ejemplo demuestra que incluso los programadores más experimentados pueden encontrar dificultades al trabajar con tecnologías fuera de su especialidad y que la IA puede ser una herramienta útil para superar esas barreras y explorar nuevos ámbitos de desarrollo.
Sin embargo, conseguir que una aplicación funcione aparentemente no garantiza que lo haga correctamente. Esta cuestión también estuvo presente durante la recuperación de Mimi, donde la IA facilitó el trabajo con componentes y tecnologías menos conocidos, mientras que las pruebas y la revisión del código permitieron detectar errores y comprobar que los cambios introducidos producían los resultados esperados. De este modo, el valor de la IA no estuvo únicamente en acelerar el desarrollo, sino también en facilitar la exploración de nuevas soluciones, manteniendo siempre un proceso de validación que garantizase su correcto funcionamiento.
Del código original a la recuperación de Mimi Reader
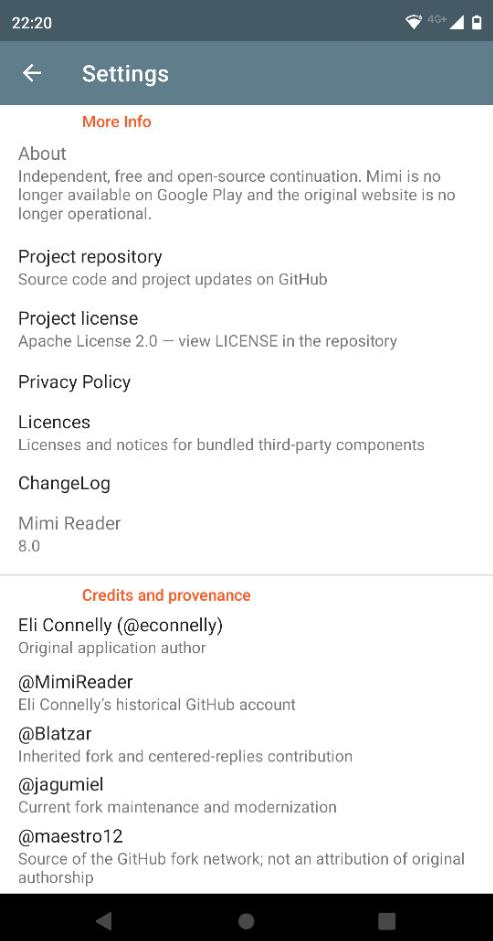
Para recuperar Mimi Reader, necesitaba localizar su código fuente. Lo encontré en GitHub, en el fork de @Blatzar, que incorporaba algunas modificaciones respecto a la aplicación original y que elegí como punto de partida. Antes de modificarlo, examiné el historial de commits para conocer la evolución del proyecto e identificar las aportaciones de sus autores. Así llegué a Eli Connelly (@econnelly), creador de Mimi Reader, cuyo trabajo también aparecía vinculado a la cuenta @MimiReader.
Una vez conocida su procedencia, revisé las condiciones de la licencia. Que un proyecto publique su código fuente no significa que podamos modificarlo o distribuirlo sin restricciones. Mimi Reader utiliza la licencia Apache 2.0, que permite ambas cosas, pero establece obligaciones como conservar los avisos de derechos de autor, incluir la licencia e identificar las modificaciones realizadas. Por ello, mantuvimos los créditos y avisos originales, junto con las licencias de los componentes de terceros, y dejamos claro que Mimi Reader 8.0 sería una continuación independiente, no una versión oficial del proyecto original.
Partir de una aplicación existente tenía ventajas, ya que funcionalidades como la navegación, la gestión de hilos y el historial estaban implementadas. Sin embargo, como usuario habitual también conocía sus problemas de estabilidad, incluidos algunos bloqueos ocasionales. Mi objetivo era corregir esos errores y modernizar Mimi Reader para las versiones actuales de Android, manteniendo la compatibilidad con dispositivos más antiguos. Esto exigía comprender el código heredado, identificar los componentes que necesitaban cambios y verificar que las funcionalidades existentes seguían funcionando correctamente. A partir de ese análisis, elaboramos una hoja de ruta (roadmap) para organizar las tareas y orientar el trabajo del agente de IA, un paso especialmente importante en un proyecto de vibe coding.
Vibe coding en Android: diagnosticar antes de cambiar el código
El punto de partida fue modernizar una aplicación antigua y conseguir que volviera a funcionar en Android actual. Primero revisamos el proyecto, el entorno de compilación y los problemas de compatibilidad. Después fuimos abordando fallos de estabilidad, navegación y multimedia, así como la inclusión de nuevos formatos para visualizar y la modernización del Captcha.
Lo primero fue analizar el código de Mimi Reader y entender qué teníamos entre manos. Revisamos la estructura del proyecto, sus módulos, las dependencias y las funciones existentes. Además, examinamos cómo resolvía la navegación, el almacenamiento y la reproducción multimedia. Ese análisis permitió valorar qué podíamos conservar y qué necesitaba modernización.
Con esa base, definimos qué queríamos corregir y qué funciones nos interesaba incorporar. También acordamos condiciones que debían orientar los cambios, como conservar datos y mantener la compatibilidad con dispositivos antiguos. Por tanto, la revisión inicial servía para decidir el alcance del trabajo antes de organizar su ejecución.
El procedimiento siguió este orden:
- Analizar el código y reconocer los componentes del proyecto.
- Entender qué funciones existían y cómo estaban implementadas.
- Definir qué queríamos conservar, corregir, modernizar o incorporar.
- Organizar esas decisiones en un roadmap con prioridades y fases.
- Mantener el roadmap actualizado conforme avanzaban el desarrollo y las pruebas.
Planificar el vibe coding con una hoja de ruta
El análisis y los objetivos acordados dieron forma a una hoja de ruta escrita. En ella agrupamos correcciones, mejoras y verificaciones, con sus prioridades y dependencias. Además, la mantuvimos como un documento vivo: la actualizábamos al completar tareas, incorporar propuestas o detectar problemas durante las pruebas.
| Bloque | Objetivo |
|---|---|
| Entorno y compatibilidad | Compilar, instalar y depurar, manteniendo Android 10 y 12 dentro del alcance. |
| Funcionamiento básico | Corregir arranque, navegación, multimedia y envío de mensajes. |
| Estabilidad y datos | Recuperar sesiones y preservar preferencias, historial y descargas. |
| Dependencias y seguridad | Revisar bibliotecas, generar el inventario de componentes y automatizar comprobaciones. |
| Distribución | Documentar, firmar y verificar la APK antes de publicar. |
La hoja de ruta para la versión 8.0 se organizó en dos líneas de trabajo. La primera tenía como objetivo recuperar una aplicación funcional y estable. Para conseguirlo, planificamos la corrección de errores, la actualización de dependencias obsoletas y la eliminación de la publicidad. También contemplamos retirar aquellas librerías que dejaran de ser necesarias durante la refactorización del código.
La segunda línea se centró en ampliar las funcionalidades de la aplicación y mejorar su compatibilidad con la imageboard. Entre las tareas previstas incluimos el soporte para vídeos MP4 y la actualización del sistema CAPTCHA, necesaria para adaptarlo a los cambios del foro y permitir la publicación de mensajes. También planteamos incorporar soporte para Flash. Aunque es un formato poco utilizado actualmente, la imageboard todavía dispone de una sección dedicada a este contenido.
Durante la planificación identificamos otras mejoras que decidimos reservar para una versión posterior. Así, las funciones adicionales de seguimiento de hilos y la actualización de Gradle quedaron previstas para la versión 8.0.1. Esta separación nos permitió delimitar el alcance de cada entrega y evitar que el proyecto creciera continuamente. En un proceso de vibe coding, contar con una hoja de ruta resulta especialmente útil para mantener las prioridades y orientar las sucesivas conversaciones con Codex.
Modernizar la arquitectura de una app Android
El proyecto conservó su módulo de aplicación y su biblioteca de acceso al servicio. A partir de esa estructura, revisamos cómo se repartían las responsabilidades. Además de la interfaz, había que atender la red, la base de datos y los recursos multimedia. En consecuencia, cada cambio debía respetar el funcionamiento de los demás componentes.
Estos fueron los principales puntos de revisión:
- Interfaz y estado: abrir pestañas, rotar el teléfono y recuperar sesiones.
- Red y errores: solicitar datos y explicar las respuestas fallidas o incompletas.
- Persistencia: actualizar la base de datos y las preferencias conservando información.
- Multimedia: cargar, reproducir, pausar y liberar recursos cuando correspondiera.
- Segundo plano: recuperar descargas tras interrupciones o el cierre del proceso.
Por ejemplo, modernizamos la gestión de pestañas con ViewPager2 y limitamos su número para controlar el consumo de memoria. Las descargas por lotes pasaron a utilizar WorkManager, con progreso, cancelación y recuperación. Asimismo, adaptamos el guardado al selector de carpetas de Android, que concede acceso al destino elegido por el usuario.
También revisamos las migraciones de Room, la biblioteca que organiza el acceso a la base de datos. El trabajo incluía restaurar preferencias y evitar operaciones de base de datos en el hilo principal. Por tanto, la arquitectura se concretaba en consecuencias visibles: una mejora de interfaz debía conservar el historial y las descargas.
Mejoras multimedia y actualización del CAPTCHA
Una vez recuperada la estabilidad de Mimi, comenzamos a incorporar nuevas funcionalidades para mejorar la experiencia de uso. Una de las primeras fue ampliar la compatibilidad multimedia, añadiendo la reproducción de vídeos MP4 al soporte existente para WebM. También corregimos un comportamiento que resultaba especialmente molesto al navegar por la galería, y es que cada vez que se abría un nuevo vídeo, el sonido volvía a desactivarse. Con los cambios introducidos, la aplicación pasó a recordar la preferencia del usuario y mantenerla durante la navegación.
Otra mejora importante fue la gestión de las imágenes y los vídeos de la galería. Incorporamos un sistema de precarga automática que permite descargar anticipadamente los archivos multimedia, reduciendo los tiempos de espera al pasar de uno a otro. Para evitar un consumo excesivo de recursos, limitamos las descargas simultáneas y dimos prioridad a los elementos más próximos al que se estaba visualizando. Posteriormente, añadimos la reproducción automática, que permite recorrer una galería sin intervenir constantemente: las imágenes avanzan tras unos segundos, los GIF al completar su animación y los vídeos cuando termina su reproducción. También incorporamos un control visible para activar o detener esta función en cualquier momento.
En paralelo, introdujimos otras mejoras prácticas, como los filtros para organizar las secciones del foro, la actualización de su catálogo y la posibilidad de refrescar las pestañas que hubieran sufrido errores de carga. También renovamos las descargas por lotes para permitir su seguimiento, cancelación y recuperación ante interrupciones, además de incorporar una opción para limpiar la caché sin eliminar los archivos descargados por el usuario.
Compatibilidad con Flash y renovación del CAPTCHA
Para la última fase dejamos dos funcionalidades que requerían una integración más específica. La primera fue recuperar el soporte para archivos Flash (SWF), todavía presentes en una sección del foro, mediante Ruffle, un emulador que permite reproducir parte de estos contenidos sin depender del antiguo Adobe Flash Player. Su integración permitió ampliar los formatos compatibles, aunque no todos los archivos podían reproducirse correctamente, bien por limitaciones del emulador o porque habían dejado de estar disponibles en los servidores originales.
La segunda fue actualizar el sistema CAPTCHA, necesario para volver a publicar mensajes y responder a los hilos. El mecanismo anterior había quedado obsoleto, por lo que tuvimos que adaptarlo al sistema de verificación utilizado actualmente por el foro. Durante las pruebas aparecieron algunos problemas, como la solicitud de un nuevo desafío después de haber resuelto el anterior, que fuimos corrigiendo hasta conseguir completar el proceso de publicación. Finalmente, verificamos el envío de una respuesta de texto desde un dispositivo con Android 12, aunque dejamos pendientes otras comprobaciones, como la publicación con archivos adjuntos y las pruebas en diferentes dispositivos.
Abordar todas estas mejoras de forma convencional, especialmente en un entorno de desarrollo con el que no estaba familiarizado, me habría llevado varios meses de trabajo. Habría necesitado dedicar mucho tiempo a comprender el código existente, familiarizarme con las bibliotecas utilizadas y determinar cómo implementar y validar cada modificación. Sin embargo, gracias al vibe coding, conseguí acelerar enormemente este proceso. Me centré exclusivamente en las decisiones de arquitectura, requisitos y diseño de soluciones a alto nivel, delegando el resto de la implementación y las pruebas al agente. Esto no eliminó la necesidad de supervisar y validar los resultados, pero sí transformó radicalmente la velocidad y la forma de abordar el desarrollo.
Limpieza de dependencias y refactorización del código
A medida que avanzábamos en la modernización de Mimi, actualizamos numerosas bibliotecas y sustituimos algunos componentes antiguos por alternativas más recientes, como ocurrió con la migración del sistema de navegación a ViewPager2. Estos cambios hicieron que parte del código heredado, así como determinadas dependencias, configuraciones y recursos, dejaran de ser necesarios. Por ello, abordamos una fase de limpieza y refactorización destinada a simplificar la estructura del proyecto, eliminar elementos obsoletos y reducir la complejidad acumulada durante años de desarrollo.
Con ayuda del agente de IA, revisamos las dependencias y sus relaciones con el resto de la aplicación para identificar qué elementos podían eliminarse sin afectar a su funcionamiento. Este proceso permitió retirar bibliotecas innecesarias, eliminar interfaces y recursos gráficos que habían quedado sin uso y reemplazar algunas integraciones antiguas por alternativas más actuales. Sin embargo, no bastaba con identificar componentes aparentemente obsoletos, ya que antes de eliminarlos, debíamos comprobar que ninguna funcionalidad seguía dependiendo de ellos y verificar mediante pruebas que los cambios no introducían nuevos errores.
Los riesgos de actualizar dependencias heredadas
Uno de los casos más interesantes surgió al actualizar Apache Commons Lang, una biblioteca que Mimi utilizaba, entre otras cosas, para interpretar determinados elementos de los comentarios. La versión instalada presentaba una vulnerabilidad conocida, por lo que decidimos actualizarla. Sin embargo, las pruebas revelaron que la versión más reciente había introducido un cambio en el tratamiento de ciertos caracteres numéricos Unicode. Aunque la biblioteca funcionaba correctamente, ese cambio podía provocar errores en el analizador de comentarios de Mimi, que no estaba preparado para interpretar esos caracteres de la misma manera.
En lugar de modificar el analizador para adaptarlo inmediatamente a ese nuevo comportamiento, optamos por una versión de Commons Lang que corregía la vulnerabilidad y mantenía la compatibilidad con el código existente. Dejamos una posible actualización posterior para una revisión independiente, evitando introducir cambios adicionales que no eran necesarios en ese momento. Tanto la decisión como las pruebas que permitieron detectar la incompatibilidad quedaron recogidas en el análisis de Commons Lang.
Este ejemplo demuestra que modernizar una aplicación no consiste simplemente en sustituir todas sus bibliotecas por las versiones más recientes. Cada modificación debe evaluarse teniendo en cuenta las particularidades del proyecto y sus posibles consecuencias. En nuestro caso, la IA facilitó el análisis y la refactorización del código, pero fueron las comprobaciones y las pruebas las que nos permitieron decidir qué cambios incorporar y cuáles convenía posponer, además de nuestro criterio.
SBOM y análisis de vulnerabilidades del software
Un SBOM, o Software Bill of Materials, es un inventario estructurado de los componentes de un programa. En Mimi utilizamos CycloneDX para representar sus dependencias y relaciones. Así podíamos identificar las bibliotecas incluidas en la versión. Además, añadimos comprobaciones para detectar cuándo el inventario dejaba de corresponderse con el proyecto.
Revisar únicamente las dependencias escritas en Gradle resultaba insuficiente. También había bibliotecas transitivas, incorporadas por otras dependencias, y componentes integrados manualmente, como Ruffle. Por tanto, el inventario debía reflejar ese conjunto. Dentro de una recuperación con IA, esta tarea ayuda a documentar qué estamos preparando para distribuir y mantener.
Analizar el inventario con Trivy
El siguiente paso fue integrar el análisis del SBOM con Trivy en GitHub Actions. La herramienta permite contrastar componentes reconocidos con avisos de vulnerabilidades conocidas. Estos pueden incluir identificadores CVE o GHSA, que sirven para referirse a problemas publicados. Además, programamos nuevas ejecuciones para detectar avisos posteriores al lanzamiento.
La política del proyecto bloquea hallazgos de severidad alta o crítica sin una excepción revisada y vigente. No obstante, los demás siguen siendo visibles en los informes. También conservamos resultados SARIF, un formato que facilita consultar hallazgos de análisis. De esta forma, las comprobaciones aportaban evidencias que podían revisarse fuera de la conversación.
En el análisis de publicación, el escáner reconoció los 148 paquetes Maven previstos y no encontró vulnerabilidades conocidas. Sin embargo, ese resultado tenía un alcance concreto y correspondía al momento del análisis. La cobertura no incluía automáticamente todo el código nativo ni las dependencias internas de WebAssembly. Esos límites quedaron documentados en el proyecto.
Spoler: 2 semanas más tarde…
La revisión de vulnerabilidades se programó en GitHub Actions para que se ejecutara de forma periódica cada semana. A las dos semanas esta acción retornaba un error. Esto significa que se ha encontrado una vulnerabilidad en alguna de las librerías del SBoM. En una futura entrada se explicará en mayor profundidad cómo programar GitHub Actions para detectar CVEs y qué hacer cuando esto ocurre.
Pruebas automatizadas y validación con GitHub Actions
A medida que avanzaba el desarrollo, necesitábamos comprobar que las modificaciones no introducían errores en funcionalidades que ya estaban operativas. Para ello, configuramos un flujo de integración continua mediante GitHub Actions, capaz de compilar la aplicación, ejecutar pruebas unitarias y realizar análisis estáticos del código. También incorporamos pruebas instrumentadas en emuladores con Android 10, 12, 14 y 16, además de verificaciones específicas para dispositivos con páginas de memoria de 16 KB.
La puesta en marcha de estas pruebas también permitió descubrir problemas que habían pasado desapercibidos. Por ejemplo, detectamos un error en la limpieza de archivos tras una descarga fallida, así como dificultades relacionadas con la visualización de PDF y la configuración de los emuladores. Cada fallo requería analizar los registros y determinar si el problema estaba en la aplicación, en las propias pruebas o en el entorno de ejecución, antes de introducir las correcciones necesarias.
Una vez más, el vibe coding facilitó enormemente el trabajo, tanto en la preparación de las pruebas como en el análisis de los resultados. Esto permitió establecer un sistema de validación reproducible sin tener que desarrollar manualmente toda la infraestructura. Aunque las pruebas automatizadas no sustituyen las comprobaciones en dispositivos reales, aportaron una mayor confianza en los cambios realizados. En una próxima entrada profundizaré en el funcionamiento de GitHub Actions y su integración en un flujo de trabajo DevSecOps.
De la compilación a una APK firmada
Conseguir una APK todavía exigía preparar su distribución. Como explica la documentación de firma de Android, el sistema requiere una firma digital para instalar o actualizar estos paquetes. La clave privada permite firmar, mientras que el certificado público identifica la firma. Por tanto, había que custodiar ambos elementos de forma adecuada.
Generamos una clave propia, protegida y fuera del repositorio. Introduje la contraseña en una consola local y mantuve separada su custodia. Además, elegimos una identidad de instalación independiente porque no teníamos la clave privada original. La nueva Mimi se instala aparte; el historial, los ajustes y las sesiones anteriores no se importan automáticamente.
Antes de cerrar la publicación comprobamos estos puntos:
- Construir la APK desde la revisión concreta que íbamos a distribuir.
- Verificar su firma frente al certificado elegido para esta continuación.
- Comprobar los archivos mediante sus checksums, o huellas de integridad.
- Instalar y comprobar el arranque en el dispositivo utilizado.
- Descargar la copia pública y contrastar de nuevo su hash y firma.
Así publicamos Mimi Reader 8.0 con checksums, certificado público, SBOM y registro de cambios. Las notas de la versión detallan las verificaciones y limitaciones. Por ejemplo, las comprobaciones físicas de Android 12 no certifican cada interacción en todos los teléfonos. La clave privada y su contraseña quedaron fuera de la distribución.
Qué aportó el vibe coding y qué decisiones tomé yo
En conjunto, la IA ayudó a explorar el código, localizar relaciones entre archivos y preparar cambios y pruebas. Además, facilitó un trabajo iterativo: investigar un fallo, modificar una parte y comprobar otra vez. El alcance del proyecto incluía tecnologías diversas. Por eso, la asistencia resultaba útil para mantener el avance entre tareas diferentes.
Mi papel consistía en fijar prioridades, probar la aplicación y decidir si el resultado respondía a lo que necesitaba. Conservar compatibilidad, proteger las descargas y mantener los créditos eran requisitos concretos. También debía distinguir las mejoras futuras de los fallos que bloqueaban el uso. Esas decisiones orientaban el trabajo del asistente.
Hubo propuestas que corregimos y modificaciones que no resolvieron el problema observado. Por tanto, la conversación necesitaba apoyarse en registros, pruebas y uso real. Hablar de vibe coding tiene sentido para explicar el punto de partida y la experimentación. La revisión del código y de sus consecuencias describe mejor cómo continuamos el proyecto.
Recuperar software con IA: lo que aprendí con Mimi
Recuperar una aplicación antigua se parece a diagnosticar un aparato que todavía queremos utilizar. Primero hay que entender su estructura y reproducir los síntomas. Después toca comprobar las consecuencias de cada reparación. La IA facilita ese recorrido y permite explorar herramientas que conocemos menos, como ilustra también el visualizador de Linus.
En Mimi, ese proceso reunió planificación, arquitectura, multimedia, dependencias y distribución. Además, incorporamos pruebas y documentación para conocer mejor el resultado. El vibe coding sirvió como punto de entrada a una experiencia más amplia de desarrollo asistido. A su vez, el código abierto hizo posible retomarla, y las comprobaciones ayudaron a decidir qué podíamos entregar.
Puedes consultar el repositorio de esta continuación de Mimi Reader y las descargas de la versión 8.0. Allí figuran también las limitaciones y comprobaciones pendientes. ¿Has utilizado IA para recuperar software o trabajar con otra tecnología? Me interesa conocer qué te ayudó y dónde encontraste sus límites.